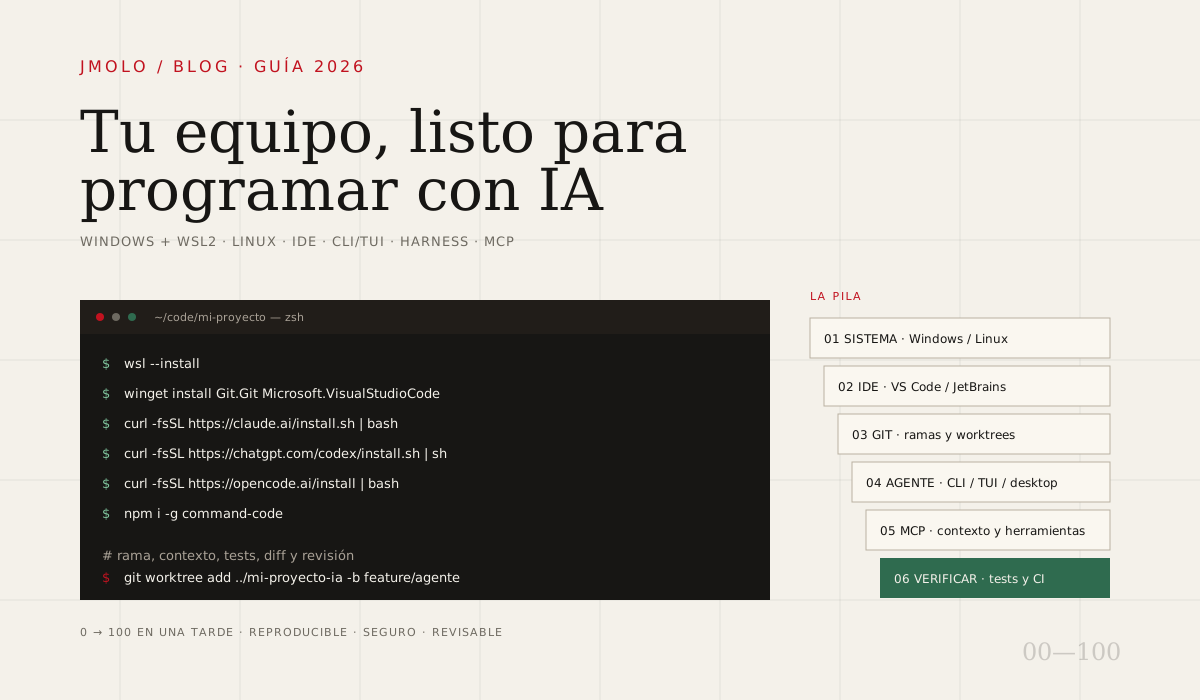
Un entorno de desarrollo con IA no es una aplicación. Es un sistema de capas: el editor donde se lee y se escribe, el lenguaje y sus herramientas, el control de versiones, la terminal, el agente que ejecuta tareas, el modelo que genera y la integración continua que verifica. Cuando una de esas capas falla, la sensación de velocidad desaparece y aparece el trabajo manual.
La conversación pública suele reducirlo a una elección: “¿qué modelo uso?”. Es la pregunta menos útil. Un modelo excelente dentro de un entorno sin pruebas, sin permisos y sin revisión produce cambios que parecen buenos y cuestan más de mantener. Un modelo modesto dentro de un flujo bien instrumentado puede ser suficiente para la mayoría del trabajo.
Este artículo describe una configuración razonable para 2026, con criterios para elegir cada pieza y reglas para que el conjunto sea seguro. No es una lista de compras: es una forma de decidir qué necesita un proyecto y qué se puede dejar fuera.
Las capas
El punto de partida es el mismo que en cualquier proyecto de software: separar responsabilidades.
- 01ProductoWeb, aplicación o herramienta
Lo que usa una persona y lo que tiene que funcionar.
- 02ProyectoRepositorio, pruebas, documentación
El estado real del trabajo: código, decisiones y verificación.
- 03HerramientasIDE, terminal, CI, preview
El entorno donde se escribe, se ejecuta y se revisa.
- 04HarnessBucle del agente y permisos
Lee, propone, ejecuta herramientas y comprueba el resultado.
- 05ModeloContexto, tokens y razonamiento
La pieza que genera, pero no la que decide el alcance.
El producto es lo que usa una persona. El proyecto es el repositorio, las pruebas y la documentación. Las herramientas son el editor, la terminal, el CI y el preview. El harness es el bucle que permite al agente leer, proponer y ejecutar. El modelo es la pieza que genera. La calidad del resultado depende de todas; el modelo solo es la más visible.
El IDE: el lugar donde se piensa
El editor sigue siendo el centro del trabajo, aunque el agente escriba más que antes. Un buen IDE aporta tres cosas que un chat no tiene: navegación, diagnóstico y ejecución. El servidor de lenguaje (LSP) entiende símbolos, tipos y referencias. El depurador (DAP) permite parar el programa y mirar el estado. El ejecutor de pruebas y la terminal integrada cierran el ciclo.
Las opciones razonables dependen del lenguaje y del estilo:
- VS Code es la base más común: extensiones, depurador, terminal, Git y una comunidad enorme. Es una buena elección si el equipo valora compatibilidad y no quiere sorpresas.
- JetBrains (IntelliJ, WebStorm, PyCharm) ofrece análisis profundo y refactorización muy sólida. El coste de licencia se justifica en proyectos grandes o con mucho código heredado.
- Zed y Neovim priorizan velocidad y teclado. Neovim exige configurar el LSP y el árbol de sintaxis; a cambio, el entorno es ligero y reproducible.
- Cursor y otros editores con agente integrado añaden el modelo dentro del editor. Son cómodos para explorar, pero conviene comprobar qué datos envía, qué permisos tiene y cómo se revisa el cambio.
El criterio no es “el más popular”, sino: ¿entiende el proyecto?, ¿ejecuta las pruebas?, ¿muestra el diff?, ¿se puede reproducir en otra máquina? Un editor que no se puede configurar desde el repositorio es una dependencia personal, no una herramienta de equipo.
El harness de escritorio: el agente con interfaz
El harness es la capa que convierte un modelo en un agente útil. Le da acceso a archivos, terminal, navegador, base de datos o GitHub; mantiene el estado de la tarea; aplica permisos; muestra los cambios; y permite aprobar o rechazar. Sin harness, el modelo es una ventana de chat. Con harness, puede ejecutar un plan y verificar el resultado.
En 2026 conviven varias familias:
- Claude Code, de Anthropic, con una interfaz de terminal y una aplicación de escritorio. Está pensado para trabajar sobre el repositorio y ejecutar herramientas.
- Codex, de OpenAI, con CLI y una experiencia integrada en la nube. Su punto fuerte es el trabajo sobre tareas y la revisión de cambios.
- OpenCode, un harness abierto con interfaz de terminal y de escritorio, pensado para conectar distintos modelos y servidores MCP.
- Aider y otras CLI especializadas, útiles para cambios acotados y flujos basados en Git.
La diferencia entre ellos no suele estar en el modelo, sino en el control. ¿Puede leer cualquier archivo? ¿Puede ejecutar comandos sin preguntar? ¿Puede tocar producción? ¿Guarda un punto de restauración? ¿Muestra el diff antes de aplicar? ¿Se integra con el editor? Esas preguntas importan más que la puntuación de un benchmark.
Un harness de escritorio es cómodo para trabajo exploratorio: ver el árbol de archivos, abrir el navegador, revisar el diff y aceptar cambios con el ratón. También es más fácil de supervisar para alguien que no vive en la terminal. El coste es que añade una interfaz que hay que aprender y, a veces, una capa propietaria sobre el repositorio.
La CLI y la TUI: el agente en el flujo
La terminal no es una moda retro. Es el entorno más reproducible que existe. Un agente en CLI puede ejecutarse en local, por SSH, dentro de un contenedor o en CI. Sus comandos se pueden versionar, repetir y auditar. Una TUI añade una interfaz visual sin abandonar la terminal: árbol de archivos, diff, estado de la tarea y permisos.
La CLI es especialmente útil para:
- Trabajo remoto. Un servidor de desarrollo, un contenedor o una máquina sin escritorio.
- Tareas repetibles. Un script que ejecuta el mismo tipo de cambio sobre varios repositorios.
- Integración con Git. Crear una rama, aplicar un cambio, ejecutar pruebas y abrir un pull request.
- Automatización. Un agente que revisa dependencias, genera documentación o comprueba enlaces.
- Depuración. Ver exactamente qué comando se ejecutó y qué salida produjo.
La contrapartida es la curva de aprendizaje y el riesgo de automatizar demasiado. Un comando mal escrito en una CLI puede hacer más daño que un clic en una interfaz, sobre todo si se ejecuta sin confirmación. La regla es la misma: permisos acotados, entorno aislado y revisión del diff.
El modelo no es el equipo
La elección del modelo debería ser una consecuencia del trabajo, no el punto de partida. Un equipo puede usar un modelo frontera para arquitectura y depuración, uno intermedio para implementación y uno flash para clasificación, extracción o pruebas. Esa mezcla se llama enrutamiento por tarea y suele ahorrar más que negociar el precio por token.
También tiene sentido tener un modelo local para datos que no deben salir. Ollama, LM Studio y soluciones similares permiten ejecutar modelos en la propia máquina. La calidad no es la de un frontera, pero para tareas acotadas y datos sensibles puede ser la opción correcta. El coste se paga en hardware, latencia y mantenimiento.
Lo importante es que el modelo sea intercambiable. Si el harness depende de una API propietaria y el proyecto no puede cambiar de proveedor, se ha creado una dependencia difícil de justificar. Un buen entorno separa el harness del modelo y permite probar alternativas sin reescribir el flujo.
MCP y herramientas
El Model Context Protocol (MCP) es un estándar para conectar modelos y agentes con herramientas y datos. Un servidor MCP puede exponer archivos, una base de datos, un navegador, GitHub o una API interna. El agente descubre las herramientas y las usa con permisos.
MCP resuelve un problema real: antes, cada integración era artesanal. También añade un problema de seguridad: cada servidor es una puerta. Un servidor MCP con acceso a la base de datos de producción es una puerta grande. Conviene aplicar el principio de mínimo privilegio:
- Usar credenciales de solo lectura cuando la tarea no necesita escribir.
- Separar entornos y datos de prueba.
- Revisar qué herramientas expone cada servidor.
- Registrar las llamadas y los cambios.
- No conectar servidores que no se entienden.
El estándar no sustituye el criterio. Un agente con veinte herramientas no es mejor que uno con tres bien elegidas.
Un flujo que funciona
La configuración importa menos que el orden. Este es un flujo razonable para un cambio de tamaño medio:
- 01
Especificar
Un documento corto con el problema, el alcance y cómo se comprobará.
- 02
Aislar
Rama o worktree. El agente no toca producción ni datos reales.
- 03
Generar
El harness lee, propone y ejecuta herramientas con permisos acotados.
- 04
Verificar
Tipos, tests, lint y una compilación real. La salida no es la prueba.
- 05
Revisar
Diff pequeño, decisiones explicadas y una persona que responde por el cambio.
- 06
Desplegar
Preview, comprobación visual y promoción a producción.
- Especificar. Un documento corto con el problema, el alcance, lo que no entra y cómo se comprobará. Si no se puede escribir, todavía no se entiende.
- Aislar. Una rama por tarea. Para trabajo en paralelo, un worktree de Git:
git worktree add ../proyecto-feature -b feature/x. El agente no toca la copia principal ni producción. - Dar contexto. Los archivos relevantes, las convenciones del proyecto y los comandos de prueba. El contexto debe ser suficiente, no infinito.
- Generar. El agente propone un plan y lo ejecuta con permisos acotados. Los cambios grandes se dividen antes de aceptarlos.
- Verificar. Tipos, pruebas, lint y compilación. En un proyecto Astro, por ejemplo,
npm run check,npm testynpm run build. La salida del agente no es evidencia; la salida del sistema sí. - Revisar. Leer el diff, buscar cambios no intencionados, dependencias nuevas y datos expuestos. Si no se entiende, no se acepta.
- Previsualizar. Un preview con datos de prueba, navegación real y comprobación visual. El código que compila no siempre se ve bien.
- Desplegar. Promover el mismo artefacto que se revisó. Nada de construir de nuevo en producción sin pasar por el mismo camino.
Este flujo es más lento que “pedir y aceptar”. También es lo que permite usar un agente todos los días sin acumular deuda.
Configuración por perfil
No todos los proyectos necesitan lo mismo. Una tabla de partida:
| Perfil | Editor | Harness | CLI | CI / preview | Prioridad |
|---|---|---|---|---|---|
| Proyecto personal | VS Code o Zed | Uno, con permisos básicos | Opcional | GitHub Actions + preview | Simplicidad |
| Estudio pequeño | VS Code o JetBrains | Escritorio + CLI | Sí, para tareas repetibles | CI con pruebas y preview | Reproducibilidad |
| Equipo con varios agentes | El que use el equipo | Varios, con permisos por rol | Sí, en contenedor | CI, preview y branch protection | Aislamiento y auditoría |
La columna “prioridad” es la que decide. Un proyecto personal no necesita una plataforma interna. Un equipo que ejecuta varios agentes en paralelo sí necesita worktrees, límites de permisos y registros. Añadir herramientas sin una necesidad concreta solo aumenta la superficie que hay que mantener.
Seguridad: lo que no se delega
Un agente puede leer archivos, ejecutar comandos y llamar APIs. Eso lo convierte en una pieza sensible. Las reglas mínimas:
- Secretos fuera del contexto. Variables de entorno, nunca en el repositorio. En Astro, cualquier variable que empiece por
PUBLIC_se incluye en el cliente; no es el sitio para una clave privada. - Permisos mínimos. El agente no necesita acceso a producción para escribir una prueba. Si lo necesita, que sea con una credencial temporal y de solo lectura.
- Entorno aislado. Contenedor, máquina virtual o worktree. El objetivo es que un error se pueda borrar sin restaurar una copia de seguridad.
- Comandos peligrosos bloqueados.
rm -rf,git push --force, migraciones destructivas y cambios en DNS no deberían ejecutarse sin confirmación explícita. - Dependencias revisadas. Un agente puede añadir un paquete sin evaluar licencia, mantenimiento o seguridad. El
lockfiley la revisión del diff son obligatorios. - Registros. Saber qué se ejecutó, cuándo y con qué resultado. Sin registro no hay auditoría.
- Datos personales. No pasar datos reales a un modelo externo si no hay base legal y garantías. Para pruebas, datos sintéticos.
La seguridad no es un módulo que se añade al final. Es una propiedad del entorno: qué puede tocar el agente, qué no y cómo se comprueba.
Coste y mantenimiento
Un entorno con IA tiene tres costes: suscripciones, API y tiempo. Las suscripciones de editores y harness son previsibles; la API variable. La partida que más crece suele ser la revisión, porque el código generado aumenta el volumen de cambios.
Para mantenerlo bajo control:
- Medir el coste por tarea aceptada, no solo por token.
- Usar caché de contexto cuando el flujo repita el mismo prefijo.
- Enrutar tareas simples a modelos baratos.
- Limitar el tamaño del contexto y de los diffs.
- Revisar suscripciones cada mes: ¿se usa el harness de escritorio o bastaría la CLI?
- No mantener dos herramientas que resuelven lo mismo.
La configuración ideal no es la que tiene más piezas. Es la que se puede explicar, reproducir y mantener con el tiempo.
Checklist mínimo
Antes de considerar que el entorno está listo:
- El repositorio tiene pruebas, tipos y lint que se ejecutan con un comando.
- Hay una rama o worktree por tarea.
- Los secretos están fuera del repositorio y del contexto del agente.
- El agente no tiene acceso a producción por defecto.
- El diff se revisa antes de aceptar.
- Hay un preview con datos de prueba.
- El despliegue usa el mismo artefacto que se verificó.
- Existe un documento con las convenciones del proyecto.
- Alguien responde por el cambio.
Conclusión
Un equipo de desarrollo en 2026 no se define por el modelo que usa, sino por el sistema que lo rodea. El IDE aporta navegación y diagnóstico; el harness, herramientas y permisos; la CLI, reproducibilidad; el CI, verificación; y la revisión, responsabilidad. El modelo es una pieza intercambiable dentro de ese sistema.
La IA permite hacer más con menos, pero no elimina la necesidad de saber qué se está haciendo. La configuración que funciona es la que hace fácil lo correcto: cambios pequeños, pruebas, aislamiento y un diff que se puede leer. Lo demás es velocidad sin dirección.
Comentarios
Conversación
Los comentarios se apoyan en GitHub Discussions. Para participar necesitas una cuenta de GitHub. Al cargar el hilo, GitHub puede usar cookies y tratar tu cuenta según su política. Más información.